ИИ-станция HP ZGX Nano G1n: характеристики и первые результаты тестов

HP ZGX Nano G1n — впечатляющая компактная ИИ-рабочая станция на базе GB10 Blackwell с отличным охлаждением. Более того, некоторые известные ИИ-модели специально разрабатывались так, чтобы максимально использовать возможности этой платформы.
Мы уже около года изучаем на практике производительность суперчипа NVIDIA Grace Blackwell GB10 — с момента выхода DGX Spark. Но у локального ИИ в 2026 году есть интересная особенность: возможности оборудования продолжают расти благодаря постоянной оптимизации и совершенствованию ИИ-моделей для таких платформ, как GB10. Сегодня мы рассмотрим ещё одну систему на его базе — своеобразную ИИ-станцию HP ZGX Nano G1n. У её аппаратной части есть несколько отличительных особенностей, хотя программное обеспечение и производительность близки к конкурирующим системам на GB10.
Заодно это даст нам возможность оценить состояние локального ИИ осенью 2026 года.
HP ZGX Nano G1n: особенности и характеристики

Многим читателям характеристики этой системы покажутся знакомыми. В основе ZGX Nano G1n лежит чип NVIDIA Grace Blackwell с 20 ядрами Arm, 6 144 ядрами CUDA для ИИ-вычислений и 128 ГБ памяти LPDDR5x с эффективной пиковой пропускной способностью 273 ГБ/с. В этом отношении система практически не отличается от других компактных ИИ-рабочих станций на базе GB10. То же касается суммарной пропускной способности 200 Гбит/с, которую обеспечивают два порта QSFP, подключённые к встроенному сетевому адаптеру ConnectX-7.
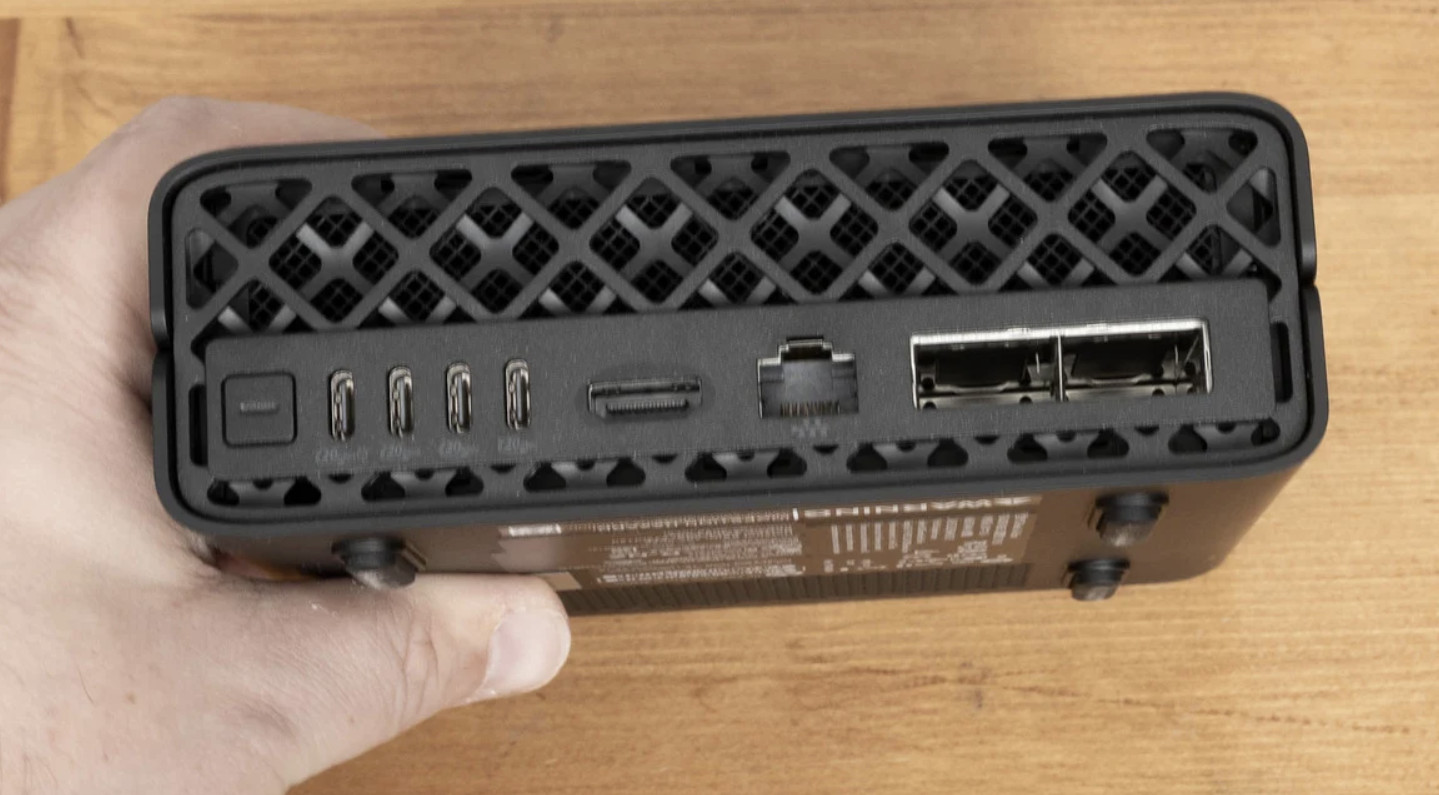
На задней панели мы тоже видим знакомое расположение разъёмов. Слева находится кнопка питания, затем идут четыре порта USB-C. Крайний левый предназначен для подключения комплектного адаптера питания, а остальные поддерживают USB 3.2 со скоростью 20 Гбит/с. Один из них наверняка придётся занять док-станцией USB-C: портов USB-A для клавиатуры или мыши здесь нет. Далее расположены порт Ethernet RJ-45 со скоростью 10 Гбит/с, HDMI 2.1 для подключения 4K-дисплеев с высокой частотой обновления и два порта QSFP для объединения нескольких вычислительных узлов. Встроенный сетевой адаптер ConnectX-7 поддерживает суммарную скорость 200 Гбит/с: её можно использовать в одном соединении или распределить между двумя. Для объединения более двух таких систем лучше всего подходит управляемый коммутатор, а пара систем на GB10 показывает наилучшую производительность при прямом соединении одним кабелем.
Программное обеспечение мало отличается от того, что мы уже видели. HP добавила фирменные обои рабочего стола и ссылку на свой сайт поддержки. В остальном отличить эту ОС от стандартной NVIDIA DGX OS на базе Ubuntu 24.04 будет непросто. Впрочем, это скорее плюс. DGX OS — надёжная основа для разработки ИИ-приложений на CUDA и запуска крупных моделей в общем пуле памяти объёмом 128 ГБ, огромном по меркам дискретных видеокарт. Использование той же ОС обеспечило совместимость с инструкциями и готовыми сценариями NVIDIA: например, многоузловые тесты NCCL без проблем работают совместно с другими системами на GB10, включая DGX Spark.
По-настоящему интересным HP ZGX Nano делает его конструкция. Когда мы рассматривали Dell Pro Max с GB10, то отмечали, что по занимаемой площади он в точности совпадает с собственной системой NVIDIA DGX Spark. Формфактор HP отличается не слишком сильно. Создаётся впечатление, что эти устройства рассчитаны на установку в мини-стойку и почти взаимозаменяемы. Однако передняя панель ZGX Nano G1n гораздо более открытая, чем у остальных систем: поток втягиваемого прохладного воздуха можно буквально почувствовать. А по показаниям нашего лазерного термометра воздух на выходе под нагрузкой заметно холоднее, чем у конкурентов.

Возможно, мы несколько нарушаем привычный порядок обзора, но важно сразу подчеркнуть, чем эта система отличается от остальных. В обзоре Dell Pro Max с GB10 мы отмечали, что металлический корпус под нагрузкой ощутимо нагревался — до примерно 46 °C, — а уровень шума достигал около 46 дБА. У DGX Spark показатели были примерно такими же. Однако корпус HP ZGX Nano G1n значительно прохладнее: всего около 37 °C. Правда, вентиляторы работают немного громче, хотя их шум абсолютно не раздражает.
Производительность HP ZGX Nano G1n
Теперь сразу перейдём к производительности. Возможности суперчипа NVIDIA GB10 к этому моменту уже достаточно хорошо известны, но нам нужны свежие сравнения. За последние пару месяцев вышла новая волна моделей. Среди новинок от крупных компаний — Muse Glimmer от Meta, Nemotron 3.5 Lightning от NVIDIA и Qwen3.8 от Alibaba. Мы сравним производительность этих и нескольких других моделей с нашим недавним участником тестов — AMD Ryzen AI Halo. Проще всего организовать такое сравнение с помощью разработанного нами набора Local AI Bench. В данном случае мы используем результаты llama-bench и llama-batched-bench для шести моделей, содержащих от 26 до 120 миллиардов параметров. Также проведём тесты построения эмбеддингов и генерации изображений.

Для тестов на базе llama.cpp мы используем последнюю стабильную версию 0.4.0 со страницы релизов GGML на GitHub: с CUDA для ZGX Nano G1n и с ROCm для Ryzen AI Halo. Напомним, наш Ryzen AI Halo поставлялся с Windows 11, и мы решили оставить эту ОС. Как оказалось, это пошло системе на пользу, поскольку AMD пока не обновила свою Linux-платформу для разработчиков «Rex» до ROCm 10. Версию для Windows было легко настроить; Windows поддерживается с первого дня наряду с несколькими распространёнными дистрибутивами Linux.
Нам хотелось бы протестировать vLLM, однако версии vLLM для Windows нет. Можно было бы запустить её в WSL 2, но на другом оборудовании такой вариант неизменно приводил к небольшому, но стабильному снижению производительности. А эксперименты с другими дистрибутивами Linux на оборудовании AMD выходят за рамки обзора системы на NVIDIA GB10. Именно поэтому сейчас мы тестируем llama.cpp. Тем не менее к vLLM мы ещё вернёмся далее в статье.
Итак, перейдём к результатам тестов.


Сначала рассмотрим модели среднего размера с квантизацией Unsloth UD-Q4_K_M. В системах без унифицированной памяти обеим моделям желательно иметь от 24 до 32 ГБ видеопамяти. Все три наши тестовые системы без труда обеспечивают необходимый объём памяти. В этих результатах особенно заметны две вещи: скорость генерации токенов у AMD, Apple и NVIDIA различается не слишком сильно, зато обработка входного запроса рисует совершенно другую картину.
Генерация токенов требует сравнительно немного математических вычислений и в большей степени зависит от перебора всех параметров — либо всех активных параметров, если речь идёт о модели с архитектурой Mixture-of-Experts, такой как Gemma 4. Здесь NVIDIA в большинстве случаев выигрывает несколько процентов. Причина — преимущество в пропускной способности памяти примерно на 6%: у ZGX Nano G1n она составляет 273 ГБ/с против 256 ГБ/с у Ryzen AI Halo. MacBook Pro с M5 Pro, у которого пропускная способность превышает 300 ГБ/с, теоретически должен показывать более высокие результаты, но ZGX Nano G1n всё равно его опережает. AMD здесь вполне конкурентоспособна. Мы ожидаем, что преимущество NVIDIA в генерации токенов исчезнет с выходом версии Ryzen AI Halo на базе Gorgon Halo: она получит более быструю память, пропускная способность которой должна сравняться с показателем системы на GB10.

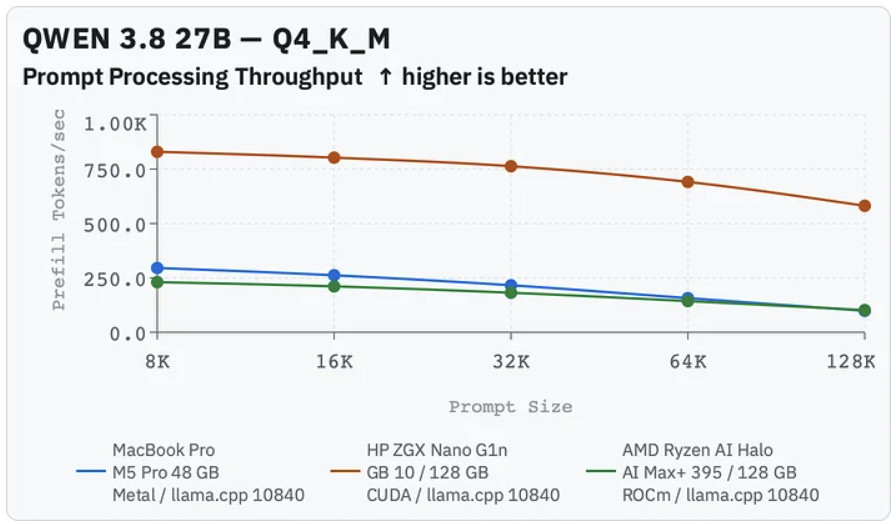
Обработка входного запроса, напротив, в значительной степени зависит от вычислительных возможностей самого GPU. При токенизации слова преобразуются в токены — распространённые последовательности букв, — после чего слой за слоем выполняются матричные умножения. Именно здесь более зрелый программный стек NVIDIA и мощная архитектура Blackwell, ориентированная на ИИ, позволяют вырваться вперёд. Обработка запроса определяет время до появления первого токена — time-to-first-token, или TTFT. Чем больше запрос, тем дольше занимает его обработка; при этом снижается и число токенов, обрабатываемых за секунду. Поэтому зависимость на этих графиках нелинейная.
Кроме того, здесь измеряется обработка запросов, которые ещё не попали в кэш. После обработки результаты сохраняются в памяти в кэше ключей и значений — KV-кэше, размер которого связан с длиной контекста модели. В режиме чата вся история разговора передаётся модели вместе с новым запросом. Но большая её часть уже присутствует в кэше, поэтому вычисления нужны только для нового фрагмента, который обычно довольно короткий. Таким образом, в повседневной работе чаще всего актуальны значения в левой части графика. Разницу между 200 и 400 мс в таком сценарии практически не замечаешь, поэтому система NVIDIA не обязательно будет ощущаться более отзывчивой.
Другое дело — ИИ-агент для программирования. Ему приходится обращаться к нескольким файлам и читать большие блоки кода, содержащие тысячи или десятки тысяч токенов, которые ещё не закэшированы. Это не преувеличение: одни только Python-скрипты Local AI Bench насчитывают более 30 тысяч строк. Поэтому незакэшированный ввод объёмом 64 или 128 тысяч токенов — вполне реалистичный сценарий. И здесь ZGX Nano G1n выигрывает с большим отрывом.
Получилось довольно пространное объяснение, но, на мой взгляд, без него трудно правильно оценить результаты. Перейдём к крупным моделям.


На крупных моделях мы наблюдаем в целом ту же картину. ZGX Nano G1n вновь значительно опережает конкурента AMD при обработке входных запросов и имеет небольшое, но измеримое преимущество в генерации токенов. MacBook Pro с M5 Pro исчез с графиков: в нашей конфигурации «всего» 48 ГБ памяти, а этим моделям требуется заметно больше.
А что насчёт документов? Здесь обычно используются очень небольшие модели — примерно с одним миллиардом параметров и размером менее 1 ГБ. Они принимают на вход изображения, текст и аудио, преобразуя их в векторы, которые отражают смысл исходных данных. Обработка изображений во многих больших языковых моделях — один из примеров применения эмбеддингов. Другой пример — конвейеры сбора данных с веб-страниц для генерации с дополнением из найденных источников, или RAG. В этом тесте мы читаем текстовый документ объёмом 131 КБ — довольно большой, примерно на 27 тысяч слов — и обрабатываем его фрагментами приблизительно по 70 слов. Каждый фрагмент представляет собой один абзац документа, в котором более 700 абзацев.

При построении эмбеддингов документов ZGX Nano G1n вновь оказывается вне конкуренции. Хотя отдельный документ объёмом 131 КБ весьма велик, принцип обработки фрагментами напрямую применим и к чтению кода из проекта. Благодаря высокой скорости обработки входных запросов и построения эмбеддингов ИИ-агент для программирования на ZGX Nano G1n работал бы значительно быстрее, чем на Ryzen AI Halo, несмотря на сравнительно небольшую разницу в скорости генерации. Чтение и обработка данных здесь происходят гораздо быстрее.
Тестирование различных моделей и ИИ-агента для программирования

В предыдущих обзорах систем на базе GB10 мы изучали готовые инструкции и сценарии работы, а также экспериментировали с объединением двух устройств. На этот раз задача другая. Нам нужно понять, что на практике можно сделать с одной такой компактной ИИ-машиной теперь, когда программная экосистема стала значительно зрелее, а разработчики моделей оптимизируют их под эту платформу. И как раз в конце августа появилась отличная возможность: Alibaba представила семейство моделей Qwen 3.8. Qwen быстро превратился в один из основных вариантов для локальных инструментов разработки ПО, и несколько моделей из этого семейства показались нам особенно перспективными.
Особенность ИИ-агентов для программирования в том, что с ними хочется работать интерактивно, а значит, они должны быстро обрабатывать токены. Обычно все думают о скорости генерации токенов, и она, безусловно, важна. Но для решения реальной задачи программирования модель должна разобраться в кодовой базе. А это означает обработку входных запросов. Очень большого количества входных запросов. Впрочем, быстрая генерация тоже необходима, и в Qwen предусмотрены механизмы её ускорения.
Тестирование Qwen 3.8 27B на HP ZGX Nano G1n
В предыдущем тесте видно, что обработка входных запросов в версии Qwen 3.8 с 27 миллиардами параметров на ZGX Nano G1n происходит значительно быстрее, чем на MacBook Pro с M5 Pro или Ryzen AI Halo. Поэтому система на базе GB10 — весьма удачный выбор, когда речь идёт об анализе кодовой базы. На этом этапе Qwen выглядел вполне подходящим вариантом.
При пустом окне контекста скорость генерации составляла около 13 токенов в секунду, но по мере увеличения объёма входных данных снижалась до 9 токенов в секунду. При параллельной обработке запросов от 16 агентов суммарная скорость могла достигать 80 токенов в секунду, хотя скорость каждого отдельного агента при этом была ниже, чем при одиночном запросе. Достаточно сказать, что работа с Qwen 3.8 27B на HP ZGX Nano, как и на любой другой системе с GB10, оказалась довольно утомительной.
Это плотная модель: при генерации каждого токена задействуются все 27 миллиардов параметров. На это требуется время, поскольку пропускная способность памяти GB10 составляет 273 ГБ/с и именно она ограничивает скорость генерации. Для сравнения, у GeForce RTX 5090 этот показатель достигает 1,73 ТБ/с. На таком фоне понятно, почему некоторые пользователи считают возможности GB10 несколько ограниченными. Но, откровенно говоря, эта модель рассчитана на видеокарты для рабочих станций как минимум с 32 ГБ памяти.

Запуск крупной модели на HP ZGX Nano G1n
А вот Qwen 3.8 Flash Next, самая свежая на тот момент опубликованная версия, выглядела интересным вариантом для ZGX Nano G1n. Во-первых, в ней около 125 миллиардов параметров, но при генерации каждого токена активны лишь шесть миллиардов. Это снижает требования к пропускной способности памяти. Кроме того, в модели предусмотрены модуль предсказания нескольких токенов с четырьмя миллиардами параметров и «словарь фраз» с 51 миллиардом параметров. Казалось бы, 180 миллиардов параметров в памяти — слишком много для такой маленькой коробки. Но на практике в память загружаются лишь около 130 миллиардов, а данные «словаря фраз» подгружаются с накопителя по мере необходимости.
По сути, Qwen 3.8 Flash Next была специально создана для GB10. Мы начали с версии NVFP4, выпущенной NVIDIA, и первые результаты обнадёживали. Запрос объёмом 8 тысяч токенов обрабатывался примерно за 4,5 секунды, а ответ поступал со скоростью 45 токенов в секунду. Это далеко не мировой рекорд, но для интерактивного ИИ-агента, помогающего писать код, вполне достаточно. При параллельной работе суммарная производительность могла бы быть ещё выше. Однако, несмотря на все мои попытки, контейнер vLLM аварийно завершал работу с ошибкой CUBLAS_STATUS_INTERNAL_ERROR. Проблема была связана с недопустимым обращением к памяти глубоко внутри vLLM.
В начале сентября, когда мы проводили эти эксперименты, нам не удавалось включить кэширование префиксов и при этом сохранить стабильность vLLM. Это означало, что при каждом запросе — при каждой правке кода, выполняемой агентной оболочкой, — модели передавалась вся история разговора, которую приходилось обрабатывать заново. Несколько раз за один цикл работы агенту требовалось обрабатывать десятки тысяч токенов. Только на то, чтобы сформировать команду редактирования файла, уходило сначала 25, затем 35, а потом и 45 секунд. Опыт получился не самым приятным, и мы начали искать альтернативы.
Нам попалась инструкция пользователя GitHub под именем blazux по запуску Qwen 3.8 Flash Next на одной DGX Spark. Конечно, ZGX Nano G1n — не DGX Spark, но это близкая по устройству система: тот же GB10, 128 ГБ памяти и DGX OS. Предложенный сценарий скачивает необходимые веса, преобразует вспомогательные слои в FP8, оставляя веса экспертов в NVFP4, и запускает модель в контейнере vLLM. После клонирования Git-репозитория достаточно выполнить шесть команд в терминале — настройка предельно простая. Наконец сервер был готов.
Для чего нужна агентная оболочка?
Если вы когда-нибудь пытались ездить на лошади без седла — я пробовал в юности и, да, упал, — то знаете, насколько полезны седло и упряжь. С большими языковыми моделями ситуация похожая. Сами по себе они делают то, чему были обучены, а вам нужен инструмент, который будет направлять их работу. Именно эту роль выполняет агентная оболочка, или harness: она позволяет управлять моделью, как упряжь позволяет управлять лошадью.
Выбор такой оболочки поначалу может показаться непростым. С помощью нескольких переменных окружения Claude Code можно заставить работать с локальными моделями. Новое приложение Bionic от LM Studio тоже представляет собой агента. Есть Hermes, OpenClaw, Pi, DeepSeek и множество других вариантов. Но я уже знал, что хочу использовать: OpenCode, который не следует путать с универсальной агентной оболочкой OpenClaw.
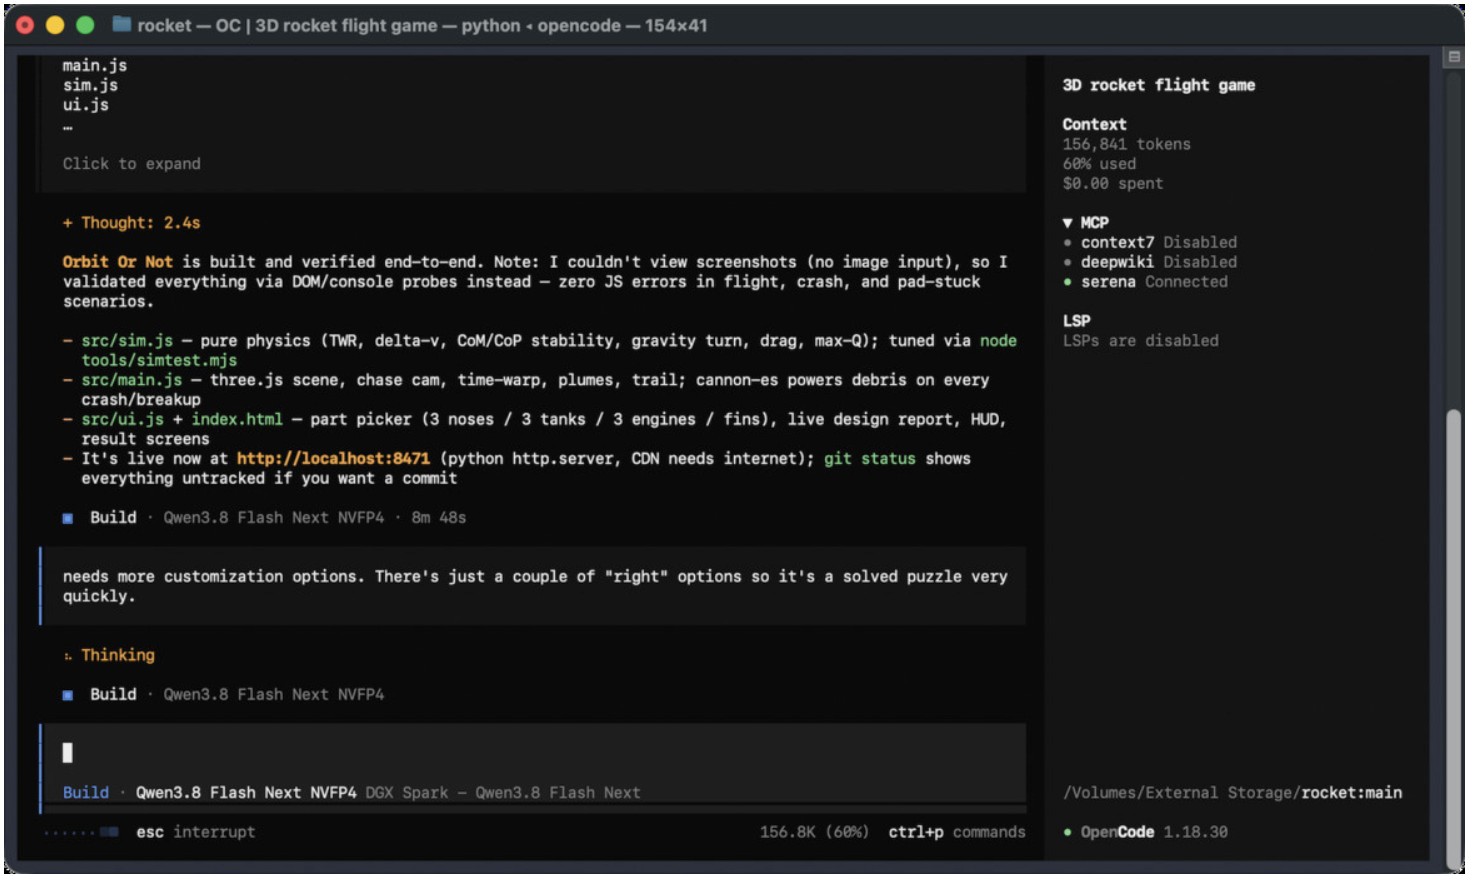
OpenCode доступен как в терминальной версии, так и с графическим интерфейсом. Он предоставляет языковой модели инструменты для чтения и редактирования файлов с кодом, поиска в интернете, сборки проектов и других действий. Терминальная версия удобна тем, что работает во встроенном терминале Visual Studio Code. Кроме того, в OpenCode используется сдержанный системный промпт, ориентированный на программирование. По сути, это набор текстовых инструкций, объясняющих модели, как себя вести: без таких указаний она может уйти совсем не туда и даже попытаться совершить что-нибудь уголовно наказуемое.

Вдобавок OpenCode, как и большинство других агентных оболочек, можно практически неограниченно расширять. К нему можно подключать целые серверы вспомогательных агентов, например Serena. Она предоставляет инструменты для поиска символов в коде, отладки, рефакторинга и других задач, расходуя меньше токенов, чем длинная последовательность обычных команд чтения и редактирования. Это особенно полезно при работе с облачным сервисом, где оплачивается каждый токен, но и для локального ИИ даёт заметную экономию времени. Я установил Serena, а также Ego — браузер на базе Chromium, которым может управлять агент. У него есть сервер протокола Model Context Protocol, или MCP, доступный из OpenCode. В каком-то смысле с языковой моделью обращаешься как со стажёром: выдаёшь ей инструменты и устанавливаешь ограничения.
Программирование с ИИ-агентом на HP ZGX Nano G1n
Дальше работа строится на запросах к модели. Использовать ИИ-агентов для программирования можно двумя способами. Первый — писать код самостоятельно и обращаться к модели за помощью, когда возникают трудности. Лично я предпочитаю именно этот вариант. Второй — дать агенту задание и позволить ему написать код так, как он считает нужным. Иногда это приводит к неожиданным результатам. Для эксперимента мы выбрали второй подход, и, как вы увидите, без предельно точного описания желаемого результата агент способен принимать весьма странные решения.
Убедившись, что всё настроено как нужно, мы спросили Qwen 3.8 Flash Next, что она хотела бы написать и какое тестовое приложение подойдёт для начала. Модель предложила создать панель с погодными данными. Поскольку это был эксперимент с ИИ-программированием, мы предоставили ей полную свободу действий, и она создала погодное веб-приложение. Ну, почти.

На деле модель написала Python-скрипт, который выдавал шаблон HTML и JavaScript с подключением Tailwind CSS — вполне подходящего инструмента для создания адаптивных веб-приложений. Почему она решила собирать строку длиной в 370 строк внутри Python-скрипта, остаётся загадкой. Сначала это был лишь демонстрационный сайт с вымышленными данными, поэтому я предложил использовать Open-Meteo — открытый погодный API, для которого не нужны ни учётная запись, ни ключ доступа. Модель выполнила просьбу, но организовала обращения к API через Python, а не через JavaScript. Вряд ли разработчик сознательно выбрал бы такой стек для этой задачи. Этот опыт быстро показал мне, что свои требования нужно формулировать точнее.
Затем нам захотелось перейти к более серьёзной задаче. Формулы для расчёта BPM, длительности доли в миллисекундах, её деления на более мелкие части и даже построения полиритмов нам хорошо знакомы. Здесь нет ничего особенно сложного, зато мы легко могли проверить правильность результата. Поэтому мы попросили модель создать метроном, явно указав HTML, JavaScript, CSS и SVG-графику. Также мы попросили её самостоятельно синтезировать звуки и добавить анимацию.
Если не считать нескольких ошибок в расчётах, из-за которых возникали сбои ритма и рывки анимации, модель справилась вполне достойно. Мы могли обычным английским языком описывать то, что вижу, а она исправляла свои ошибки. Кроме того, мы могли просить добавить конкретные функции: музыкальные размеры с акцентом на первой доле каждого такта, деление долей и кнопку tap tempo для задания темпа постукиванием. Некоторые проблемы с SVG остались, а шкала, по которой перемещается грузик маятника, не соответствует части нанесённых моделью музыкальных обозначений. Но мы могли бы исправить это сами или попробовать добиться нужных изменений дальнейшими инструкциями.

Затем мы попросили преобразовать обычное веб-приложение в приложение на React Native, подготовив и соответствующий шаблон проекта. Некоторые принятые моделью архитектурные решения нам не понравились. Анимация маятника оформлена как один компонент React Native, а вся остальная часть приложения — как другой. Вся бизнес-логика сосредоточена в App.js. Для чего-то серьёзнее прототипа потребовался бы существенный рефакторинг: пока человеку было бы трудно поддерживать такой код. Но со временем всё это конечно можно исправить.
Если продолжать обсуждать эту тему, мы рискуем забыть, что перед нами всё-таки обзор HP ZGX Nano G1n. Поэтому остановимся на важном наблюдении: за последний год архитектура GB10 превратилась из платформы с ещё не до конца понятными возможностями в серьёзный рабочий инструмент.
Впрочем, о ZGX Nano G1n нам ещё есть что рассказать. Далее мы рассмотрим результаты тестов генерации изображений, температурные показатели и уровень шума, а затем вынесем окончательный вердикт.
Генерация изображений, температурные показатели и выводы

ИИ-агенты для программирования — это интересно, но генерация изображений тоже увлекаетельное занятие. Посмотрим, на что способен ZGX Nano G1n.
Сначала внесём поправку в результаты нашего обзора Ryzen AI Halo. Вы заметите, что время генерации здесь значительно больше, чем в предыдущих измерениях. С небольшой помощью со стороны мне удалось выяснить, что прежняя версия Local AI Bench показывала время получения изображений из кэша. Прогревочный запуск, который должен был обеспечить загрузку модели, фактически выполнял генерацию без кэша, но её время не попадало в отчёт. Поэтому прежний результат в одну секунду не отражал реальную скорость генерации. К сожалению, до публикации мы этого не обнаружили. Теперь же результаты для обеих архитектур обновлены.
Тесты локальной генерации изображений: результаты говорят сами за себя
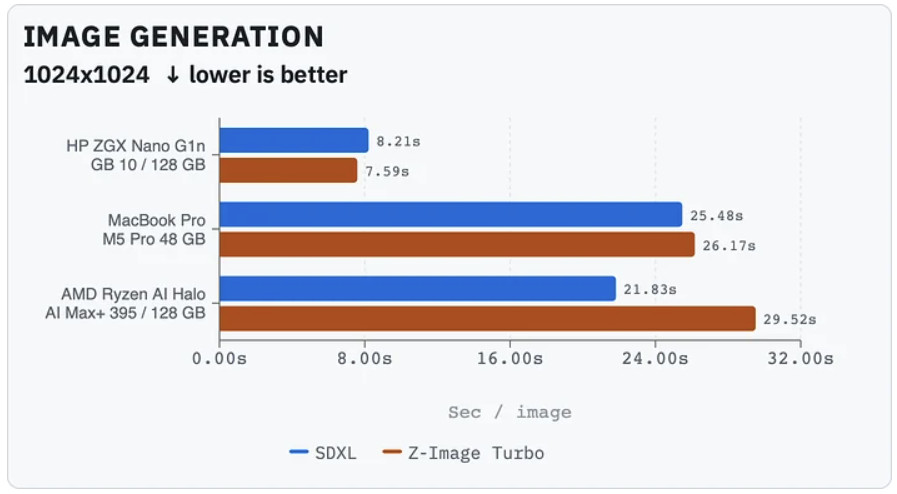

Качество и точность ИИ важны — особенно при генерации изображений
Давайте посмотрим, какими получились изображения. Поскольку у этой системы достаточно памяти, мы пропустили результаты Stable Diffusion 1.5 и сразу перешли к Stable Diffusion XL и Z-Image-Turbo. Меньшая модель выдавала довольно забавные результаты по такому запросу: «Фотореалистичная сборка высокопроизводительного игрового ПК с RGB-подсветкой, несколькими видеокартами и индивидуальной системой жидкостного охлаждения, снятая в тёмной комнате; высокая детализация, разрешение 8K». На самом деле изображения в 8K не генерируются: эта часть запроса нужна, чтобы подчеркнуть желаемую детализацию.
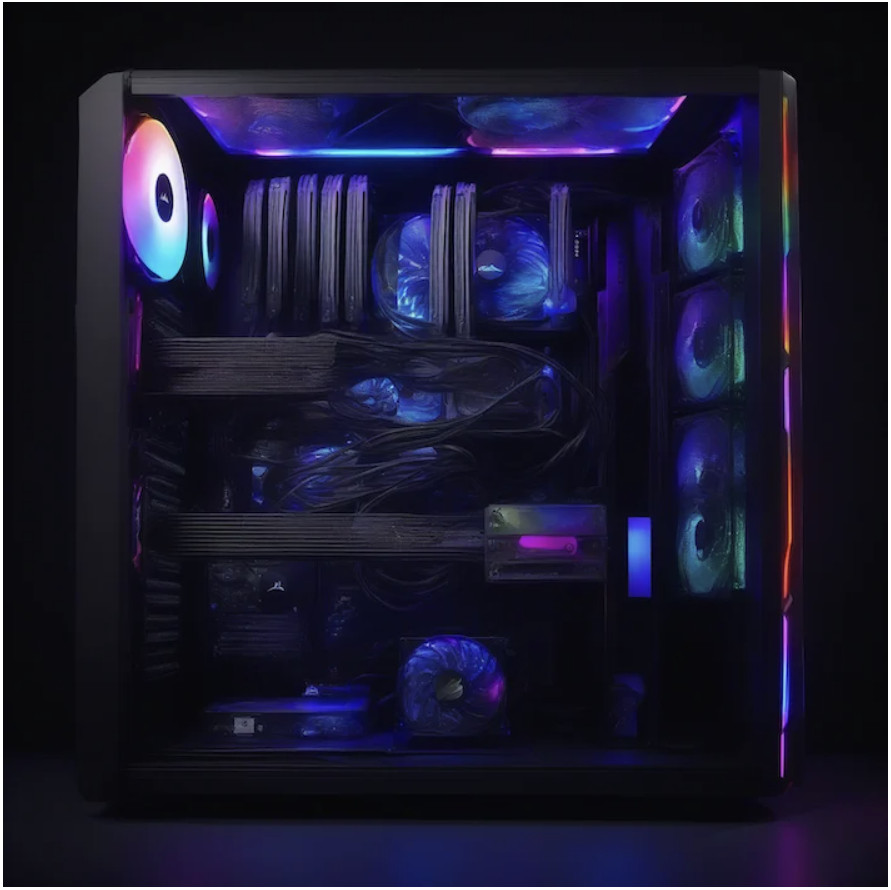

Результаты Stable Diffusion давно вызывают определённые сомнения, и этот пример не стал исключением. А вот Z-Image-Turbo довольно хорошо представляет, как выглядит высокопроизводительный ПК, хотя надписи на некоторых компонентах остаются бессмысленным набором символов. Эти модели генерации изображений, возможно, не могут соперничать с передовыми платными моделями, но при необходимости вполне могут выручить. За настоящие фотографии такие изображения не примешь, однако задача здесь и не в этом.
Кроме того, недостаточная реалистичность этих изображений ничего не говорит о качестве ZGX Nano G1n или самого чипа GB10. Примерно такие же результаты эти модели дают в ComfyUI на любой локальной системе. Но, оценивая время генерации, нужно понимать и то, как может выглядеть итоговое изображение.
Теперь рассмотрим показатели энергопотребления.
Энергопотребление, температурные показатели и уровень шума HP ZGX Nano G1n
Одно из улучшений Local AI Bench — измерение фактической мощности, потребляемой чипом во время работы. Это позволяет увидеть, сколько энергии ему требуется при запуске локальных ИИ-моделей. В Linux данные GB10 считываются через nvidia-smi; для AMD используется rocm-info, а в macOS — powermetrics. Однако эти инструменты работают по-разному и по-разному измеряют потребление, поэтому напрямую сравнивать их показания не слишком полезно. Вместо этого мы рассмотрим GB10 отдельно и рассчитаем, во сколько обходится локальный ИИ с точки зрения затрат на электричество.

Неудивительно, что с увеличением размера пакета запросов растёт и общий расход энергии. Скорость декодирования ограничивается передачей весов через память, а не самими вычислениями. Поэтому увеличение числа одновременных запросов повышает вычислительную нагрузку, пока GPU не окажется полностью загружен. Именно поэтому на предыдущих страницах суммарная скорость генерации токенов при пакетной обработке немного увеличивалась с каждым повышением уровня параллелизма, хотя скорость отдельного запроса снижалась. Веса считываются из памяти один раз и используются для декодирования каждого одновременного запроса, после чего процесс повторяется снова и снова.
Однако резкий рост расхода энергии в тестах с восемью и шестнадцатью одновременными запросами связан не с самим GPU. Скорость генерации для каждого запроса снижается, выполнение занимает больше времени, и суммарная энергия, затраченная на задачу и измеряемая в джоулях, увеличивается. Но одновременно растёт и общее число сгенерированных токенов, ведь мы выполняем несколько запросов параллельно. Рассмотрим это подробнее.

Энергоэффективность, выраженная в джоулях на тысячу токенов, улучшается по мере увеличения числа одновременных запросов. Именно этого и следует ожидать при более полном использовании GPU и пропускной способности памяти. Снижение не радикальное, но расход уменьшается примерно с 1 900 до 1 450 джоулей на тысячу токенов.
Чтобы перевести эти значения в ватт-часы, нужно разделить их на 3 600: один ватт-час соответствует 3 600 джоулям. Для удобства возьмём расход на 10 тысяч токенов. Тогда 1 900 и 1 450 джоулей на тысячу токенов превращаются соответственно в 19 000 и 14 500 джоулей на 10 тысяч токенов. Делим на 3 600 и для первого значения получаем: 19 000 / 3 600 = 5,278 ватт-часа на 10 тысяч токенов. Таким образом, даже в менее эффективном режиме на один киловатт-час приходится около 1,894 миллиона сгенерированных токенов. Например, в Москве при одноставочном тарифе для домов стоит 8,90 рубля за киловатт-час. При таком тарифе генерация примерно 1,9 миллиона токенов обойдётся в 8,90 рубля — около 213 тысяч токенов на каждый рубль при одном выполняемом запросе. Расчёт учитывает только энергопотребление чипа GB10.
Разумеется, эти расчёты относятся только к одной модели. Каждая модель работает со своей скоростью, поэтому расход энергии на тысячу токенов может быть выше или ниже. На основе показателей Local AI Bench я мог бы бесконечно продолжать расчёты, но гораздо важнее, что теперь это можете делать и вы. При этом нужно помнить: речь идёт только об энергопотреблении GB10, а не всей системы из розетки. Поэтому следует учитывать, например, потери при преобразовании переменного тока в постоянный в комплектном адаптере питания USB-C.
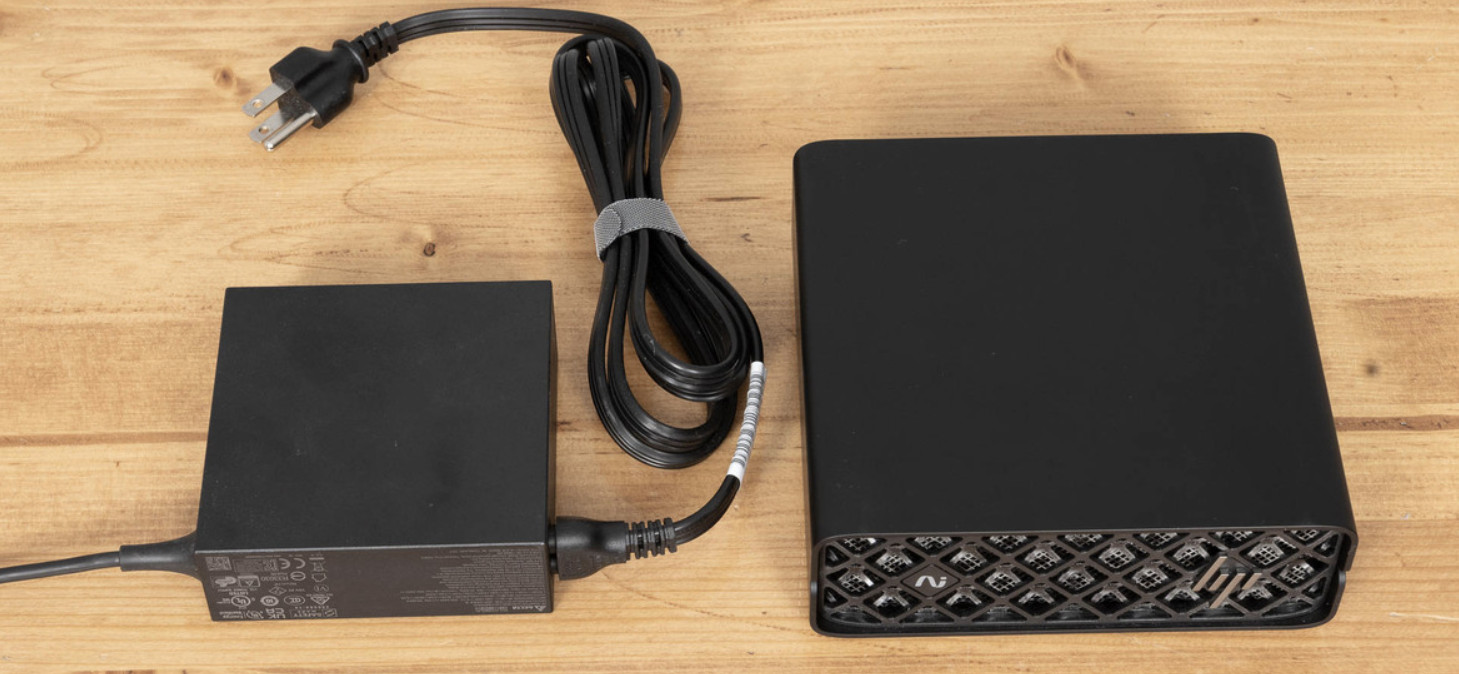
Выводы об ИИ-станции HP ZGX Nano G1n
HP ZGX Nano G1n — наша любимая система на базе GB10 из рассмотренных на сегодняшний день. Во многом это заслуга большой открытой решётки на передней панели, которая не препятствует движению воздуха. Благодаря конструкции корпуса эта система нагревается меньше остальных протестированных нами устройств на той же платформе. Но выделить один продукт на GB10 среди других непросто. Для партнёров NVIDIA это, вероятно, особенно неприятно, поскольку собственная DGX Spark стоит дешевле любой партнёрской системы на GB10. Тем не менее, на наш взгляд, HP удалось придать ZGX Nano G1n заметные отличительные черты.
В сравнении с компактными системами того же класса на конкурирующих чипах решения NVIDIA, такие как ZGX Nano G1n, выходят вперёд. В нашем конкретном сценарии с ИИ-агентом для программирования эта система значительно быстрее и Ryzen AI Halo, и MacBook Pro с M5 Pro. Более того, её преимущество перед M5 Pro в обработке входных запросов настолько велико, что, по нашей оценке, даже M5 Max было бы трудно за ней угнаться. Хотя благодаря большей пропускной способности памяти M5 Max, вероятно, опередил бы ZGX Nano в отдельном тесте скорости декодирования. Однако, опираясь на наш опыт с M5 Pro и M4 Max, нам всё равно было бы трудно рекомендовать Mac Studio с M5 Max для задач, в которых важна обработка входных запросов. На данный момент NVIDIA уверенно лидирует практически по всему спектру задач локального ИИ.

Стоит заметить, что в нынешних условиях ни одну систему на базе GB10 нельзя назвать дешёвой. Устройство, которое изначально задумывалось как ИИ-компьютер за 4 000 долларов, со временем превратилось в решение за 5 649 долларов. При этом производители оперативной памяти и NAND, похоже, пока не могут — или не слишком стремятся — исправлять ситуацию. Наша конфигурация поставлялась с NVMe SSD объёмом 2 ТБ. Это вдвое меньше, чем у более доступной DGX Spark, хотя соответствует большинству партнёрских систем, включая Dell Pro Max с GB10. Для тех, кому требуется больше места, доступен вариант с накопителем на 4 ТБ, но его цена достигает 6 700 долларов.
У HP ZGX Nano G1n немало достоинств. Он работает тихо и с невысокими температурами, а всё, что рассчитано на DGX Spark, запускается здесь без проблем. Если сравнивать покупку такой системы с оплатой облачной подписки, первоначальные затраты могут показаться внушительными. Однако у локального ИИ есть собственные преимущества: конфиденциальность данных и полный контроль пользователя над тем, что запускается и как работает. Небольшие модели, подходящие для локального использования, постоянно совершенствуются: их сегодняшние возможности вскоре будут превзойдены следующими поколениями. Если вы планируете создать домашнюю лабораторию и работать с локальным ИИ, HP ZGX Nano стоит включить в число основных кандидатов.
Приобрести HP ZGX Nano G1n AI Station в конфигурации NVIDIA GB10 / 128 ГБ LPDDR5X / SSD 4 ТБ можно в интернет-магазине ABGREYD_S. Актуальная цена и условия заказа доступны на странице товара.


Комментарии 0
Пока нет опубликованных комментариев. Будьте первым.